오래된 영문 책을 스캔한 PDF에서 글자가 검색되지 않는다면 Rescribe로 OCR을 실행해 텍스트와 검색 가능한 PDF를 만들 수 있습니다. 공식 사이트는 Windows·macOS·Linux용 1.4.0을 무료로 배포합니다. 특히 옛 인쇄본을 위해 만든 도구라서, 이 글은 Windows에서 파일을 고르고 옛 영문 책 PDF를 넣어 결과를 확인하는 순서를 안내합니다.
이미지로 저장된 책과 PDF에 검색할 수 있는 글자를 더합니다
스캐너로 만든 PDF는 화면에 글자가 보여도 문서 안에 검색할 수 있는 텍스트가 없을 수 있습니다. Rescribe는 이런 문서의 이미지를 읽어 글자를 인식하는 OCR 도구입니다. 공식 안내는 책 페이지가 들어 있는 폴더, PDF 파일, Google Books를 입력으로 제시합니다. 처음 사용할 때는 자신이 가지고 있는 스캔 PDF 한 개로 시작하면 파일 선택과 결과 확인이 단순합니다.
처리가 끝나면 검색 가능한 PDF와 전체 내용을 모은 텍스트 파일이 만들어집니다. 페이지별 일반 텍스트와 hOCR 파일, 인식 신뢰도를 살펴볼 수 있는 그래프도 결과 목록에 포함됩니다. PDF를 다시 읽을 때는 검색 가능한 PDF를 열고, 문장만 복사하거나 수정하려면 텍스트 파일을 확인하세요. 이미지 품질이 낮은 원본에서 인식된 문장을 검토 없이 그대로 인용하면 오탈자가 남을 수 있습니다.
공식 화면의 상단에는 Choose folder, Choose PDF, Get Google Book이 나란히 있습니다. 그 아래에서 Language / Script를 선택하고 Start OCR을 누르는 구성입니다. 책 사진이 여러 장 들어 있는 폴더와 이미 만들어진 PDF 중 어떤 자료를 넣는지에 따라 첫 버튼이 달라집니다. 화면에 보이는 언어 예시는 라틴 문자용이므로, 자신의 문서 언어에 맞는 설정을 따로 확인해야 합니다.
Rescribe의 실제 PDF 선택·OCR 실행 화면
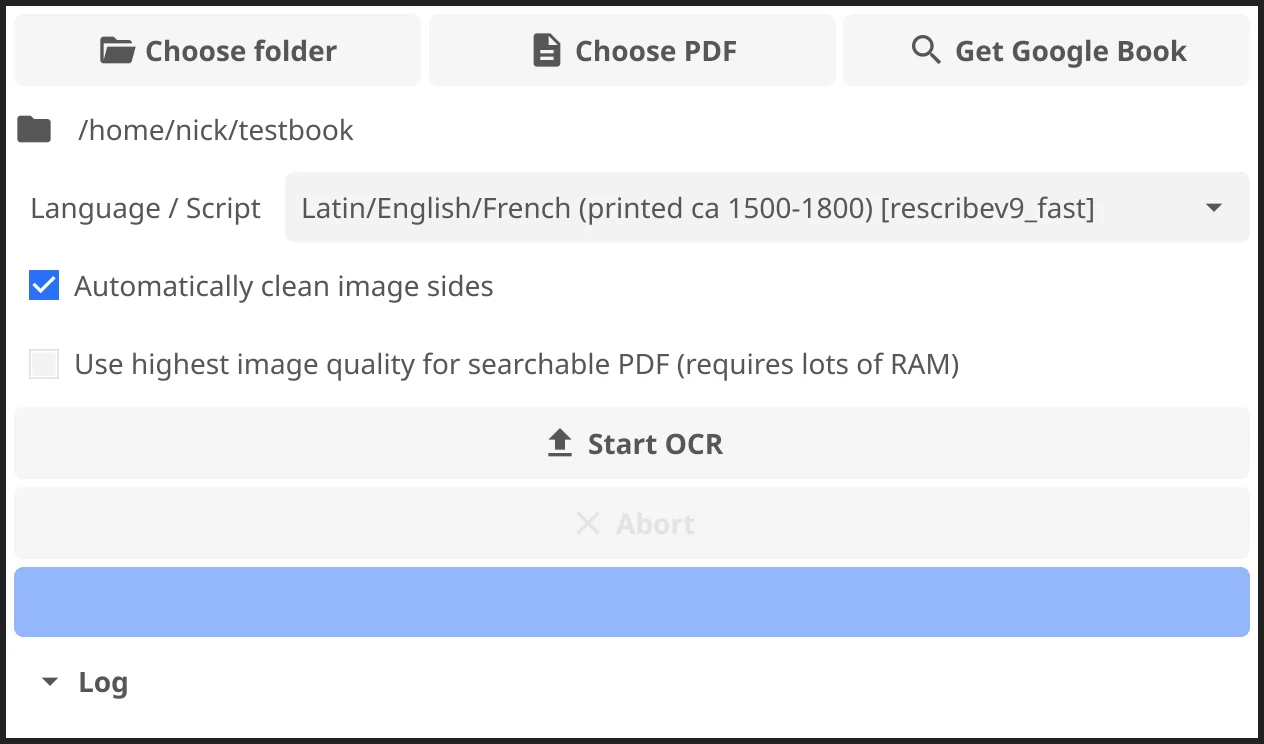
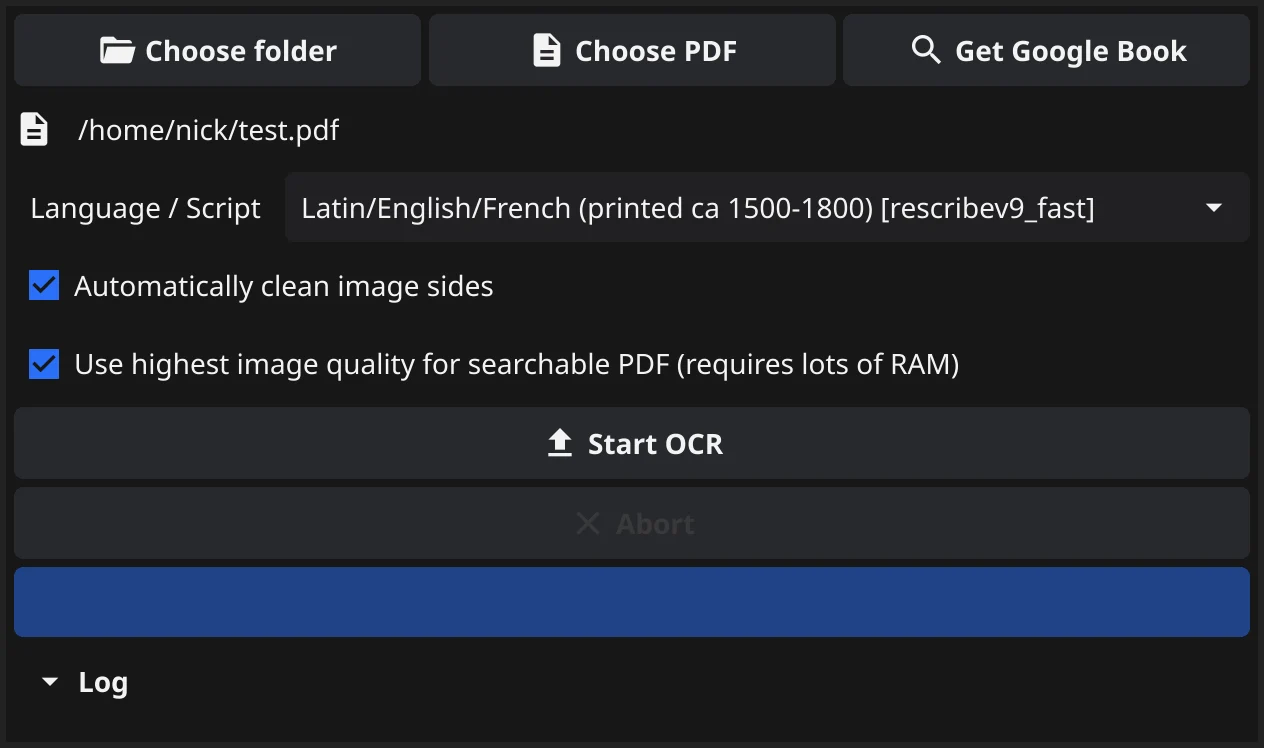
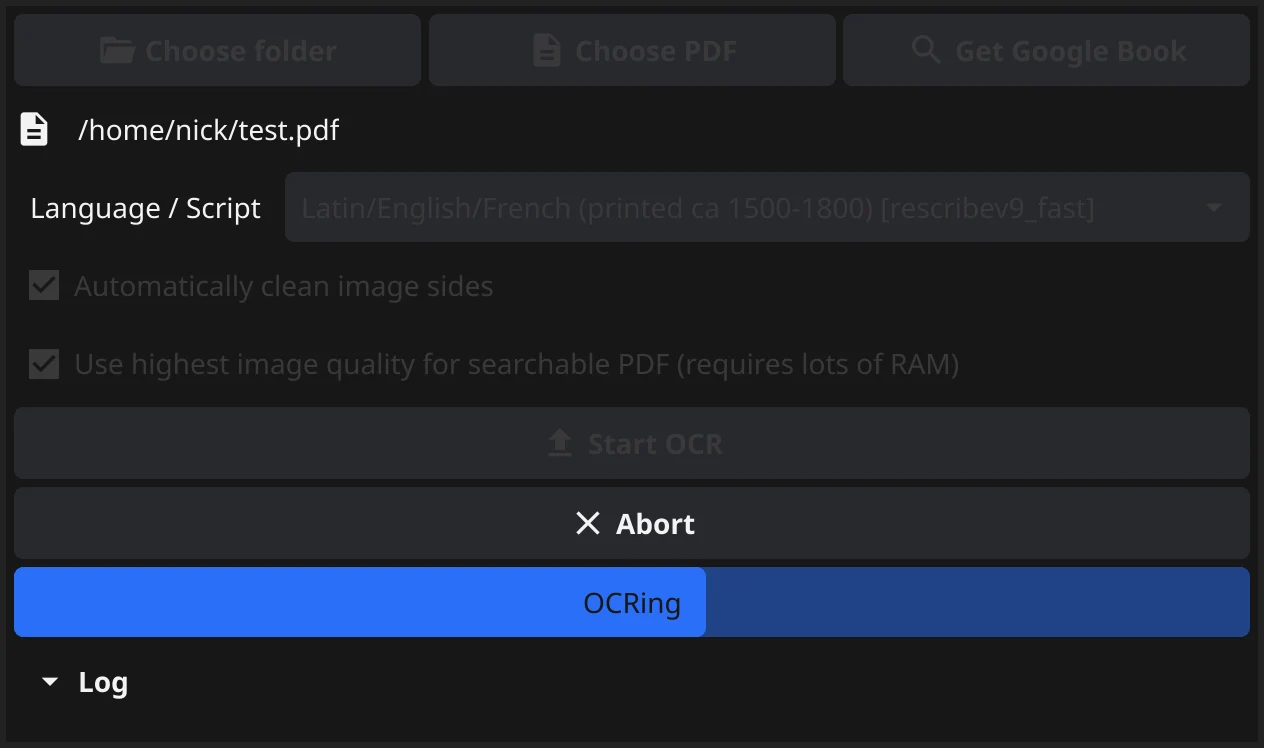
제작자가 공개한 화면입니다. 예시의 언어 설정은 라틴 문자용이며 한국어 인식 예시는 아닙니다.
| 프로그램 | Rescribe |
| 확인 버전 | 1.4.0 |
| 지원 환경 | Windows · macOS · Linux |
| 가격 | 무료 |
| 주요 용도 | 스캔 PDF·이미지 OCR |
| 결과 | 검색 가능한 PDF·텍스트 |
공식 1.4.0 파일에서 Windows용을 고릅니다
Rescribe 공식 다운로드 페이지에는 1.4.0 Windows, Mac, Linux 항목이 따로 있습니다. Windows PC에서 사용할 때는 Windows라고 표시된 항목을 고르세요. Linux는 별도 파일과 Flathub 경로가 함께 안내되고, Mac은 Mac용 파일로 분리되어 있습니다. 운영체제 이름과 버전을 먼저 확인하면 다른 기기용 파일을 저장하는 실수를 줄일 수 있습니다.
공식 사이트의 1.4.0 배포 날짜는 2025년 12월 2일입니다. 파일 이름에 버전이 표시된다면 페이지의 번호와 대조하세요. 배포 페이지의 파일 형식이나 저장 위치는 브라우저 설정에 따라 보이는 방식이 다르므로, 다운로드가 끝난 뒤 저장 폴더에서 파일을 확인합니다. 이 프로그램의 화면에는 설치 뒤 선택해야 할 입력 종류가 명확하게 나뉘어 있으므로, 처음부터 여러 보조 언어 파일을 받기보다 필요한 문서 언어를 먼저 정하는 편이 편합니다.
Windows 항목은 rescribe.exe 파일로 제공됩니다. 공식 사이트에는 별도의 설치 마법사 순서가 적혀 있지 않으므로, 저장한 파일 이름과 위치를 확인하고 Rescribe를 열어 시작하세요. 창에서 Choose PDF와 Language / Script, Start OCR이 보이는지 확인하면 첫 작업의 시작점입니다. 입력을 고르는 버튼은 위쪽에, 언어 선택은 그 아래에, 실행 버튼은 화면 중간에 있습니다. 처음에는 긴 책 전체보다 한두 페이지짜리 스캔 파일을 골라 결과 파일이 어디에 생기는지 확인하면 다음 작업을 이어가기 쉽습니다.
- 공식 사이트에서 Rescribe 1.4.0 for Windows를 선택합니다.
- 저장한
rescribe.exe의 위치를 확인하고 프로그램을 엽니다. - Rescribe를 열어 Choose PDF, Language / Script, Start OCR을 확인합니다.
스캔 PDF를 선택하고 문서 언어를 맞춥니다
한 파일로 정리된 스캔 문서는 Choose PDF에서 고릅니다. 책 페이지가 JPG·PNG 같은 이미지 여러 장으로 저장되어 있다면 Choose folder로 그 이미지가 모인 폴더를 선택하세요. 공식 화면에서는 선택한 PDF나 폴더 경로가 상단 버튼 바로 아래에 나타납니다. 경로가 원하는 원본을 가리키는지 확인하고 OCR을 시작하면 다른 자료를 처리하는 실수를 피할 수 있습니다.
다음은 Language / Script입니다. 화면 예시는 옛 인쇄본에 맞춘 Latin/English/French 모델을 선택하고 있습니다. 영문이나 다른 언어로 된 문서라면 실제 문서의 언어와 글자 형태에 맞는 항목을 고릅니다. 한국어 자료를 처리하려면 공식 추가 언어 페이지에 있는 Tesseract Korean 학습 파일을 살펴보세요. 공식 안내는 추가 파일을 사용하려면 Language / Script의 Other…에서 해당 파일을 선택하라고 설명합니다. 한국어 모델이 기본 목록에 들어 있다고 가정하지 마세요.
원본에서 책 페이지 가장자리의 얼룩이나 여백이 글자 인식에 방해된다면 Automatically clean image sides 설정을 확인합니다. 검색 가능한 PDF의 이미지 품질을 높이는 선택지도 있지만 공식 화면에 메모리 사용량이 크다고 표시되어 있습니다. 처음에는 기본 설정으로 짧은 PDF를 처리해 보고, 결과 이미지가 너무 흐릴 때만 그 옵션을 검토하세요. 긴 책 전체를 처음부터 고품질로 처리하면 완료까지 오래 걸릴 수 있습니다.
- 한 개 PDF면 Choose PDF, 여러 이미지 파일이면 Choose folder를 선택합니다.
- 선택된 경로와 Language / Script의 언어를 원본과 대조합니다.
- 필요한 경우에만 이미지 가장자리 정리와 PDF 이미지 품질 옵션을 조정합니다.
Start OCR을 누르고 검색 가능한 PDF를 확인합니다
원본과 언어를 맞췄다면 Start OCR을 누릅니다. 화면 아래의 진행 표시와 Log 영역에서 작업 상황을 볼 수 있습니다. 처리 중에는 원본 크기와 페이지 수에 따라 시간이 달라질 수 있으므로, 중간에 창을 닫기 전에 로그와 진행 상태를 확인하세요. 공식 사이트는 완료 뒤 책 이름을 붙인 검색 가능한 PDF와 전체 텍스트 파일을 결과로 설명합니다.
예를 들어 폴더 이름이 mybook이면 공식 문서의 예시는 mybook searchable.pdf와 mybook.txt입니다. 실제 이름은 선택한 원본에 따라 달라지므로 저장 위치에서 생성된 파일을 확인하세요. PDF를 열어 원본에 보이는 단어 하나를 검색하면 새 텍스트 계층이 만들어졌는지 살펴볼 수 있습니다. 텍스트 파일도 열어 문단이 어느 정도 정확히 읽혔는지 비교하세요. 자동 인식은 원본의 해상도와 글자 상태에 영향을 받습니다.
문서 전체 문장을 편집할 때는 합쳐진 텍스트 파일이 편하고, 특정 페이지의 오탈자를 찾을 때는 페이지별 text 폴더가 도움이 됩니다. 공식 안내에는 hocr 폴더와 인식 신뢰도를 나타내는 graph.png도 있습니다. 일반 독자는 먼저 검색 가능한 PDF와 전체 텍스트를 확인하면 충분합니다. 숫자나 고유명사가 중요한 계약서·자료라면 원본 페이지와 OCR 결과를 직접 대조한 뒤 사용하세요.
검색 가능한 PDF를 만들었다고 해서 원본의 모든 글자가 정확히 옮겨졌다는 뜻은 아닙니다. 예를 들어 글자처럼 보이는 얼룩이나 인쇄가 희미한 부분은 텍스트 파일에서 다른 문자로 나타날 수 있습니다. 결과 PDF에서 찾으려는 단어가 검색되지 않으면 그 페이지의 텍스트 파일을 열어 실제로 어떤 글자로 인식됐는지 보세요. 한 페이지에서만 문제가 생겼다면 그 페이지의 원본 이미지와 언어 설정을 먼저 확인하고, 전체 페이지에서 같은 문제가 반복되면 선택한 모델과 원본 품질을 함께 살펴보는 편이 좋습니다.
- Start OCR을 누르고 진행 표시와 Log를 확인합니다.
- 완료 후 생성된 검색 가능한 PDF와 전체 텍스트 파일을 찾습니다.
- PDF에서 단어 검색을 해 보고 텍스트 파일의 인식 결과를 원본과 비교합니다.
PDF를 읽지 못하거나 글자가 틀릴 때 확인합니다
Choose PDF로 파일을 선택했는데 이미지 추출 단계에서 실패한다면, 공식 문제 해결 안내에 같은 상황이 있습니다. 일부 PDF는 Rescribe가 안의 이미지를 제대로 꺼내지 못할 수 있습니다. 이때는 PDF의 페이지 이미지를 별도 폴더로 준비한 뒤 Choose folder에서 그 폴더를 입력으로 사용하라고 안내합니다. 원본 PDF를 지우지 말고 별도 폴더를 만들어 작업하면 결과와 원본을 비교하기도 쉽습니다.
결과는 나왔지만 글자가 많이 틀리면 먼저 Language / Script가 문서 언어와 맞는지 살펴보세요. 공개 화면에 있는 옛 라틴어 인쇄본용 모델은 한국어 문서에 맞지 않습니다. 한국어는 공식 추가 언어 목록의 Korean 학습 파일을 Other…에서 선택하는 방식이 안내되어 있습니다. 글자가 작거나 이미지가 기울고 흐린 경우에도 오류가 늘 수 있으므로, 짧고 선명한 원본 한두 장으로 설정을 먼저 확인하세요.
작업이 이유를 알 수 없이 멈출 때는 창의 Log 영역에 메시지가 남았는지 확인합니다. 공식 사이트는 문제를 문의할 때 해당 로그 메시지를 함께 보내 달라고 합니다. Windows의 설치 문제, PDF의 이미지 추출 문제, 언어 모델 선택 문제는 증상이 다르므로 같은 해결법을 무조건 적용하지 마세요. 설치 전에 받은 파일이 Windows 1.4.0인지, OCR 단계에서는 어떤 입력을 선택했는지 순서대로 나눠 보면 원인을 좁힐 수 있습니다.
한글 인식을 시도할 때는 추가 모델의 이름만 보고 결과를 판단하지 말고 짧은 샘플을 먼저 처리해 보세요. 공식 추가 언어 페이지는 Korean 외에 세로쓰기용 Korean vertical도 나누어 안내합니다. 일반 가로쓰기 문서와 세로쓰기 자료의 모델 선택은 다릅니다. 문서의 글 방향을 보고 필요한 파일을 고른 뒤 Other…에서 적용하는 순서입니다. 실무 문서의 중요한 숫자, 사람 이름, 날짜는 자동 인식 결과를 원본과 대조해야 합니다.
자주 묻는 질문
Rescribe는 무료인가요?
네. 공식 사이트가 1.4.0 파일을 제공하고, Flathub도 무료로 표시합니다. 소스는 GPLv3로 공개되어 있습니다.
Windows에서도 스캔 PDF를 검색 가능하게 만들 수 있나요?
네. 공식 사이트에 Windows용 1.4.0이 있고, Choose PDF에서 원본을 고른 뒤 OCR을 실행하는 흐름을 안내합니다.
사진 여러 장도 처리할 수 있나요?
네. 이미지가 모인 폴더를 Choose folder에서 고르는 방식이 공식 사용법에 있습니다.
한국어 문서는 어떻게 설정하나요?
공식 추가 언어 페이지의 Tesseract Korean 학습 파일을 확인하고 Language / Script의 Other…에서 선택합니다. 기본 내장 여부는 확인하지 못했습니다.
결과 파일은 무엇이 생기나요?
공식 안내는 검색 가능한 PDF, 전체 텍스트 파일, 페이지별 text·hOCR 파일 등을 설명합니다. 먼저 PDF 검색과 전체 텍스트 내용을 확인하세요.
짧은 스캔 PDF 한 개로 결과를 먼저 확인하세요
Rescribe 1.4.0을 설치한 뒤 Choose PDF에서 원본을 고르고, 문서에 맞는 Language / Script를 선택해 Start OCR을 누르세요. 완료되면 검색 가능한 PDF에서 단어를 찾아 보고 텍스트 파일을 원본과 비교하면 첫 작업을 마칠 수 있습니다. 한국어 자료라면 추가 언어 파일을 먼저 확인하고, 이미지 추출이 안 되는 PDF는 페이지 이미지를 폴더로 준비해 다시 시도하세요.
공식 자료와 확인일
Rescribe 공식 다운로드·사용법·오류 안내 · Rescribe 공식 추가 언어 모델 안내 · Rescribe Flathub 무료 배포와 지원 환경 | 2026-11-11T02:54:25Z