
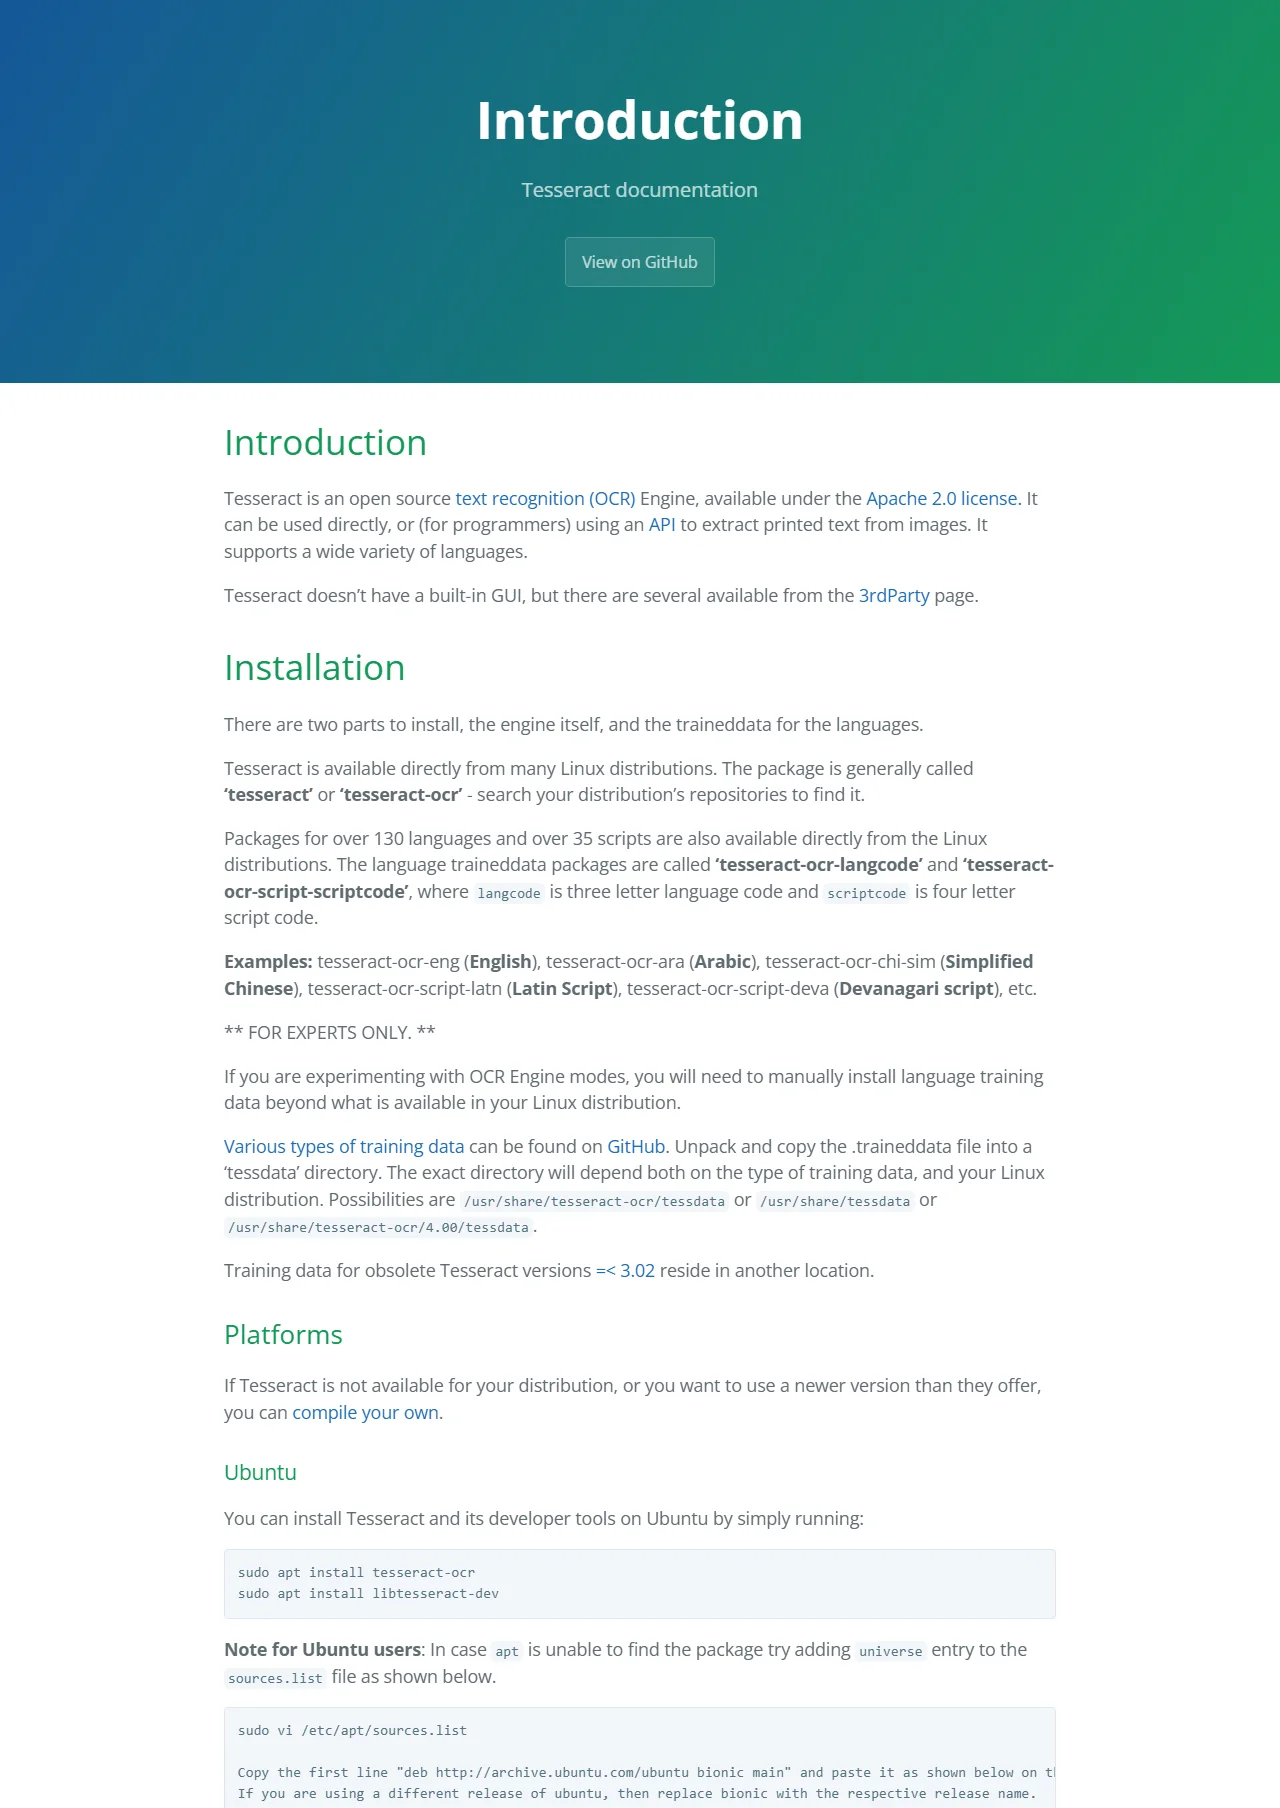
Tesseract OCR은 사진과 스캔 이미지의 글자를 읽어 텍스트나 검색 가능한 PDF로 저장하는 무료 오픈소스 문자 인식 엔진입니다. Windows에서는 공식 설치 문서가 안내하는 UB Mannheim 설치 파일을 이용할 수 있습니다.
이 글에서는 Windows 설치 파일 선택, PATH와 한국어 모델 설정, 이미지 한 장을 TXT로 변환하는 실제 명령, 한영 혼합·PSM·PDF 출력, 언어 데이터와 파일 경로 오류 해결을 순서대로 설명합니다.
Tesseract OCR은 어떤 프로그램인가요?
Tesseract는 스캔 이미지에서 문자 모양을 분석해 편집 가능한 텍스트로 바꾸는 OCR 엔진입니다. 100개가 넘는 언어와 스크립트를 지원하며 언어 모델을 추가해 한국어와 영어를 함께 인식할 수 있습니다.
자체 창이나 문서 스캐너 기능은 없고 명령줄 또는 다른 앱에서 엔진으로 동작합니다. 입력 이미지를 준비하고 언어·페이지 배치·출력 형식을 지정한 뒤 생성된 TXT나 PDF를 확인하는 방식입니다.
Tesseract 공식 OCR 입력 예시와 문서 배치 화면
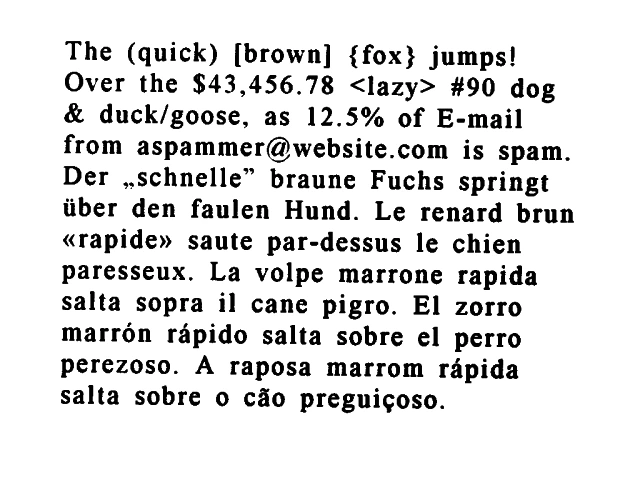
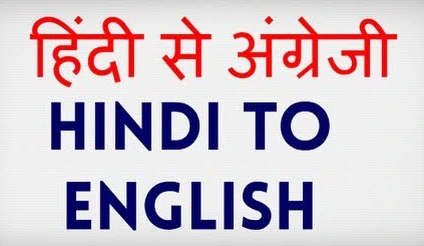
공식 Tesseract 문서에 실린 영문, 다국어, 두 단 문서 입력 예시입니다. Tesseract 자체에는 GUI가 없으므로 실제 작업에서는 이 같은 이미지를 명령줄에 입력하고 생성된 TXT·PDF를 확인합니다.
| 기본 실행 | 명령줄 |
|---|---|
| 한국어 모델 | kor.traineddata |
| 기본 출력 | UTF-8 TXT |
| 추가 출력 | PDF·TSV·hOCR |
| 복수 언어 | kor+eng |
| 페이지 분할 | PSM 0~13 |
| Windows 경로 | C:\Program Files\Tesseract-OCR |
| 내장 GUI | 없음 |
Tesseract OCR 5.5.3 무료 사용 범위와 지원 환경
Tesseract OCR은 이미지와 스캔 문서에서 문자를 읽어 TXT, PDF, TSV, hOCR 같은 결과로 내보내는 무료 오픈소스 문자 인식 엔진입니다. Apache 2.0 라이선스로 공개되며 Windows, macOS, Linux에서 명령줄이나 다른 프로그램의 OCR 엔진으로 사용할 수 있습니다.
현재 상위 프로젝트의 안정 버전은 5.5.3입니다. 다만 상위 프로젝트는 Windows 실행 파일을 직접 만들지 않으며 공식 설치 문서는 UB Mannheim이 제공하는 Windows 설치 프로그램을 안내합니다. Windows용 최신 공개 설치 프로그램은 5.4.0.20240606이고, 5.5.3은 소스 코드로 받을 수 있습니다.
Windows 설치 파일과 5.5.3 소스 코드 선택
64비트 Windows에서 바로 사용하려면 공식 설치 문서가 안내하는 tesseract-ocr-w64-setup-5.4.0.20240606.exe 파일을 선택합니다. 크기는 50,175,248바이트이며 설치 뒤 기본 경로는 C:\Program Files\Tesseract-OCR입니다.
Linux는 배포판 패키지 관리자, macOS는 Homebrew나 MacPorts를 쓰는 방법이 공식 문서에 정리돼 있습니다. 개발자가 직접 빌드할 때만 5.5.3 소스 ZIP을 선택하고, 일반 Windows 사용자는 빌드 도구가 필요 없는 UB Mannheim 설치 파일이 간단합니다.
- 64비트 Windows에서는 tesseract-ocr-w64-setup-5.4.0.20240606.exe를 받으세요.
- 설치 구성 요소에서 Tesseract core와 필요한 언어 데이터를 선택하세요.
- 설치가 끝나면 명령 프롬프트를 새로 열어 PATH 변경을 반영하세요.
- tesseract –version을 실행해 버전과 Leptonica 정보가 나타나는지 확인하세요.
- tesseract –list-langs를 실행해 eng, osd와 추가한 kor가 보이는지 확인하세요.
설치 뒤 PATH 등록과 버전 확인
명령 프롬프트에서 tesseract –version을 입력했을 때 명령을 찾을 수 없다는 메시지가 나오면 C:\Program Files\Tesseract-OCR을 Windows PATH에 추가합니다. 기존 명령 프롬프트에는 변경이 반영되지 않으므로 창을 닫고 새로 열어 다시 실행하세요.
PATH를 바꾸기 어려우면 C:\Program Files\Tesseract-OCR\tesseract.exe처럼 전체 경로를 적어 실행할 수 있습니다. 버전 정보가 표시되면 실행 파일 설치가 끝난 것이고, 다음으로 인식할 언어 데이터를 확인합니다.
한국어 kor.traineddata 설치
한국어 인식에는 kor.traineddata가 필요합니다. 설치 프로그램에서 Korean 언어를 선택하지 않았다면 공식 tessdata_fast 저장소의 kor.traineddata를 받아 C:\Program Files\Tesseract-OCR\tessdata 폴더에 넣습니다.
관리자 권한 때문에 해당 폴더에 바로 저장되지 않으면 먼저 다운로드 폴더에 받은 뒤 관리자 권한으로 복사하세요. tesseract –list-langs 결과에 kor가 나타나면 한국어 모델을 읽을 수 있는 상태입니다.
이미지 한 장을 TXT로 변환
명령 형식은 tesseract 입력이미지 출력이름 -l 언어코드입니다. 예를 들어 sample.png에서 한국어와 영어를 함께 읽으려면 tesseract sample.png result -l kor+eng를 실행합니다. 출력이름에는 확장자를 붙이지 않아도 result.txt가 만들어집니다.
완료 뒤 같은 폴더의 result.txt를 열어 문단 순서와 숫자, 영문 고유명을 확인하세요. 인식 결과를 원본 이미지 위에 직접 덮어쓰지 않으므로 입력 파일과 결과 파일을 따로 관리할 수 있습니다.
- 글자가 선명한 PNG 또는 TIFF 이미지를 작업 폴더에 준비하세요.
- 명령 프롬프트에서 cd 명령으로 작업 폴더로 이동하세요.
- tesseract sample.png result -l kor+eng를 실행하세요.
- result.txt를 열어 줄 순서와 오인식 글자를 확인하세요.
- 필요하면 이미지를 기울기 보정한 뒤 같은 명령으로 다시 비교하세요.
한국어와 영어를 함께 인식하는 언어 순서
한글 문서에 영문 제품명이나 숫자가 섞였으면 -l kor+eng를 사용합니다. 공식 문서는 언어 순서에 따라 처리 시간과 결과가 달라질 수 있다고 설명하므로 kor+eng와 eng+kor를 각각 시험해 실제 문서에 더 정확한 조합을 고르세요.
필요하지 않은 언어를 많이 더하면 처리 시간이 늘고 비슷한 모양의 글자를 잘못 선택할 수 있습니다. 문서에 실제로 쓰인 언어만 지정하고 결과 TXT에서 이름, 날짜, 금액처럼 중요한 항목을 원본과 대조하세요.
페이지 분할 모드 PSM 선택
기본 페이지 분할 모드는 PSM 3으로, 방향과 스크립트를 자동 감지하지 않고 페이지를 자동 분할합니다. 한 줄만 있는 이미지에는 –psm 7, 한 단어에는 –psm 8, 여러 칼럼이 있는 일반 문서에는 기본값이나 –psm 3을 먼저 시험합니다.
표, 영수증, 포스터처럼 배치가 복잡하면 tesseract –help-psm으로 모드 설명을 확인하고 같은 입력에 여러 모드를 적용해 비교하세요. PSM은 언어 모델을 바꾸는 옵션이 아니라 글자 영역을 어떻게 나눌지 결정하는 옵션입니다.
검색 가능한 PDF와 TSV·hOCR 출력
검색 가능한 PDF를 만들려면 tesseract scan.png result -l kor+eng pdf를 실행하면 result.pdf가 생성됩니다. 텍스트 위치가 필요한 후처리에는 tsv, 웹 문서 구조에는 hocr 출력 형식을 사용할 수 있습니다.
PDF 결과는 원본 이미지와 인식 텍스트 계층을 함께 담으므로 파일 크기가 TXT보다 큽니다. 생성한 PDF에서 검색 기능으로 고유한 단어를 찾아 보고, 복사한 문장이 원본과 일치하는지 확인한 뒤 보관하세요.
두 단 문서와 공백 보존
신문이나 보고서처럼 두 단으로 나뉜 문서는 공식 예제처럼 페이지 분할이 중요합니다. 문서 가장자리를 잘라 내고 배경을 정리한 뒤 기본 PSM 3부터 시험하며, 결과 문단이 왼쪽 단 다음 오른쪽 단 순서로 이어지는지 확인하세요.
코드나 표처럼 공백이 의미 있는 입력은 preserve_interword_spaces=1 설정을 함께 시험할 수 있습니다. 인식 엔진은 표의 셀 구조를 스프레드시트로 완벽히 복원하는 도구가 아니므로 TSV 위치 정보나 별도 표 추출 도구가 필요할 수 있습니다.
인식률을 높이는 이미지 준비
글자가 너무 작거나 흐린 사진은 OCR 전에 회전, 원근, 대비와 노이즈를 정리합니다. 공식 FAQ는 300 DPI 수준의 입력을 출발점으로 권장하며, 텍스트 주변 여백이 지나치게 없거나 너무 넓어도 페이지 분할에 영향을 줄 수 있습니다.
한 번에 모든 보정을 적용하지 말고 원본을 보존한 채 기울기 보정본, 흑백본, 확대본을 따로 만들어 같은 명령으로 비교하세요. 결과 TXT의 오류 유형을 보고 숫자, 자음, 문장 순서 중 무엇이 나아졌는지 판단합니다.
Error opening data file 오류 해결
Error opening data file 메시지는 지정한 언어 모델을 tessdata 폴더에서 찾지 못할 때 주로 발생합니다. kor.traineddata 파일명이 정확한지, 파일이 HTML 다운로드 페이지로 잘못 저장되지 않았는지, –list-langs에 kor가 나타나는지 확인하세요.
TESSDATA_PREFIX를 직접 설정했다면 값은 tessdata 폴더 자체가 아니라 그 상위 설치 폴더를 가리키도록 확인합니다. 다른 버전의 traineddata를 섞었을 때도 오류가 날 수 있으므로 5.x 계열과 맞는 공식 tessdata, tessdata_best 또는 tessdata_fast 파일을 사용하세요.
입력 파일을 열 수 없을 때
read_params_file, cannot open input file 같은 오류가 나오면 먼저 파일 경로를 확인합니다. 폴더명에 공백이 있으면 입력과 출력 경로를 큰따옴표로 감싸고, Windows 탐색기에서 숨긴 확장자 때문에 sample.png.png가 되지 않았는지 살펴보세요.
네트워크 드라이브나 클라우드 자리 표시자라면 파일을 로컬 폴더에 완전히 내려받아 다시 실행합니다. JPG가 다른 이미지 프로그램에서도 열리지 않으면 OCR 옵션보다 원본 파일 손상부터 해결해야 합니다.
한글이 깨지거나 결과가 비어 있을 때
결과 파일은 UTF-8 텍스트이므로 메모장이나 편집기에서 UTF-8로 엽니다. 빈 결과가 나오면 이미지에 실제 글자 영역이 있는지, 글자와 배경의 대비가 충분한지, PSM이 문서 배치에 맞는지 확인하세요.
한국어 문서인데 -l eng만 지정하면 한글을 제대로 읽지 못합니다. kor 모델 설치 뒤 -l kor 또는 -l kor+eng로 다시 실행하고, 사진이 옆으로 돌아가 있다면 먼저 회전한 뒤 인식률을 비교하세요.
GUI가 필요할 때 알아둘 점
Tesseract 자체에는 내장 그래픽 화면이 없습니다. 공식 문서의 이미지 예시는 OCR 입력과 명령 결과를 설명하기 위한 자료이며, 실제 작업은 명령줄에서 진행하거나 Tesseract를 사용하는 별도 GUI 프로그램을 선택합니다.
별도 GUI는 프로젝트와 배포자가 다르므로 해당 앱의 라이선스, 업데이트와 다운로드 주소를 따로 확인하세요. Tesseract 엔진 버전과 kor.traineddata 위치가 GUI 설정에 올바르게 연결돼야 같은 인식 결과를 얻을 수 있습니다.
자주 묻는 질문
Tesseract OCR은 무료인가요?
네. Apache 2.0 라이선스로 공개된 무료 오픈소스 OCR 엔진입니다.
Windows에서는 어떤 파일을 설치해야 하나요?
64비트 Windows는 공식 설치 문서가 안내하는 tesseract-ocr-w64-setup-5.4.0.20240606.exe를 사용할 수 있습니다.
한국어 인식 파일은 어디에 넣나요?
kor.traineddata를 기본 설치 기준 C:\Program Files\Tesseract-OCR\tessdata에 넣고 –list-langs로 확인합니다.
한글과 영어를 한 번에 읽을 수 있나요?
kor와 eng 모델이 설치돼 있으면 -l kor+eng를 지정해 함께 인식할 수 있습니다.
Tesseract에 화면으로 조작하는 GUI가 있나요?
아니요. Tesseract 자체는 명령줄 엔진이며 GUI가 필요하면 별도 프로그램을 선택해야 합니다.
Windows 설치와 kor 모델을 확인한 뒤 첫 이미지를 변환하세요
Windows 설치 파일을 실행한 뒤 버전 명령과 설치 언어 목록 명령으로 엔진과 kor 모델을 확인하세요. sample.png를 준비해 tesseract sample.png result -l kor+eng를 실행하고 result.txt를 원본과 대조하면 첫 OCR 작업을 끝낼 수 있습니다.
공식 자료와 확인일
Tesseract OCR 공식 5.5.3 릴리스 · Tesseract 공식 설치 문서 · Tesseract 공식 명령줄 사용 문서 · Tesseract 공식 언어 데이터 안내 | 2026-09-30T13:49:17.609936+09:00





