웹페이지나 문서가 한 화면에 들어오지 않고, 캡처한 이미지에서 글까지 옮겨야 하나요? jietuba는 스크롤 화면을 이어 붙이는 긴 캡처와 이미지의 글자를 선택해 복사하는 OCR을 갖춘 무료 윈도우 프로그램입니다. 공식 GitHub 2.1.5 릴리스에서 PC 종류에 맞는 ZIP 파일을 받을 수 있습니다.
Windows x64에서 OCR을 바로 준비하려면 PP-OCR 모델이 들어 있는 Full 패키지를 고르세요. 캡처 영역을 정하고 긴 화면을 이어 저장한 다음, 글자가 필요한 부분은 OCR로 읽어 복사하는 순서로 작업할 수 있습니다. Lite와 ARM64 파일의 차이도 아래에서 구분합니다.
화면 한 장으로 끝나지 않을 때 쓰는 캡처와 글자 인식
jietuba는 선택 영역·창 캡처, 스크롤 캡처, 그림 주석, OCR, 화면에 이미지 고정, 클립보드 기록, GIF·MP4 녹화 기능을 한 프로그램에 넣었습니다. 이 글은 긴 화면을 하나의 이미지로 저장하고 그 안의 글자를 꺼내는 작업에 집중합니다. 이미지에 글자를 그려 넣는 기능과 OCR로 글자를 읽는 기능은 서로 다른 도구이므로 원하는 결과를 먼저 구분하세요.
공식 편집 화면에는 캡처한 영역의 테두리와 아래쪽 도구막대가 보입니다. 도구막대에는 긴 캡처를 뜻하는 세로 스크롤 아이콘과 글자 인식 아이콘, 펜·도형·글자 주석 등이 있습니다. README의 편집 GIF는 제작사가 제공한 실제 사용 화면이지만 촬영 버전은 표기되지 않았습니다. 2.1.5 릴리스의 새 도구막대 이미지는 별도로 확인할 수 있습니다.
2.1.5부터 긴 캡처는 마우스 휠 입력만 세지 않고 화면 내용의 변화를 감지합니다. 따라서 스크롤 막대를 끌거나 키보드로 페이지를 넘겨도 이어 붙일 수 있습니다. 화면의 반복 무늬가 많거나 한 번에 너무 멀리 이동하면 겹치는 부분을 찾지 못할 수 있으므로, 캡처 영역의 본문이 조금씩 이어지도록 움직이세요.
OCR은 Windows 11 캡처 도구의 글자 인식과 패키지에 포함된 PP-OCR 가운데 사용 가능한 엔진을 고릅니다. Full은 PP-OCR 모델을 포함하고, Lite는 Windows 11의 캡처 도구 11.2308 이상에 기대므로 환경을 먼저 확인해야 합니다. 기본 자동 선택은 Windows 캡처 도구 OCR을 우선하며 설정의 OCR Settings에서 엔진을 바꿀 수 있습니다. 인식한 글자는 결과 창에서 선택해 복사할 수 있습니다.
스크린샷과 OCR 처리는 공식 설명상 로컬에서 이뤄집니다. 별도 번역 기능을 선택하면 사용자가 지정한 외부 번역 서비스로 문장이 전송될 수 있지만 긴 캡처와 OCR에는 번역 계정이 필요하지 않습니다. 남에게 받은 화면에 민감한 정보가 있으면 저장하거나 복사하기 전에 캡처 범위를 다시 살펴보세요.
jietuba 공식 화면: 영역 편집, OCR 결과와 2.1.5 도구막대
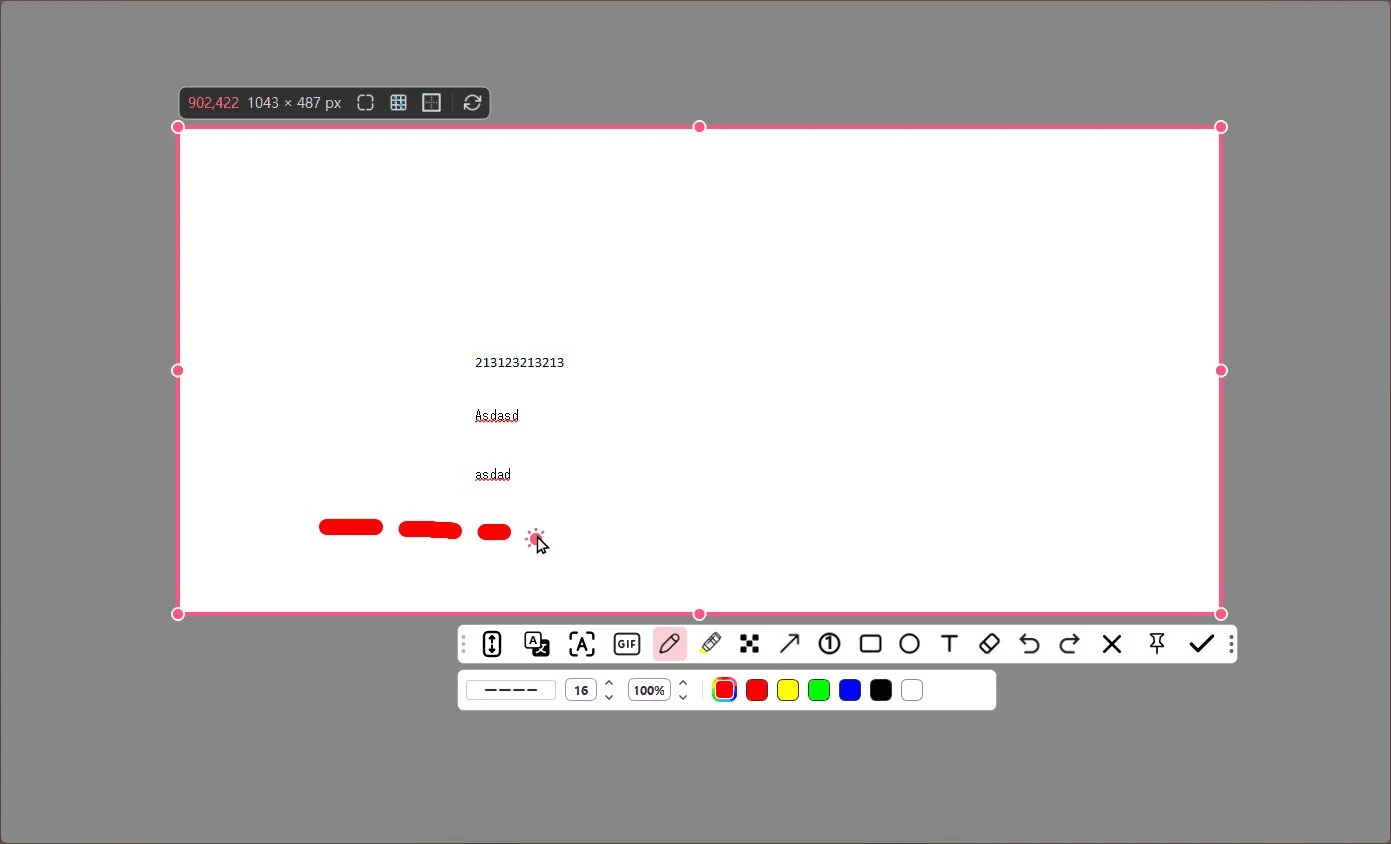
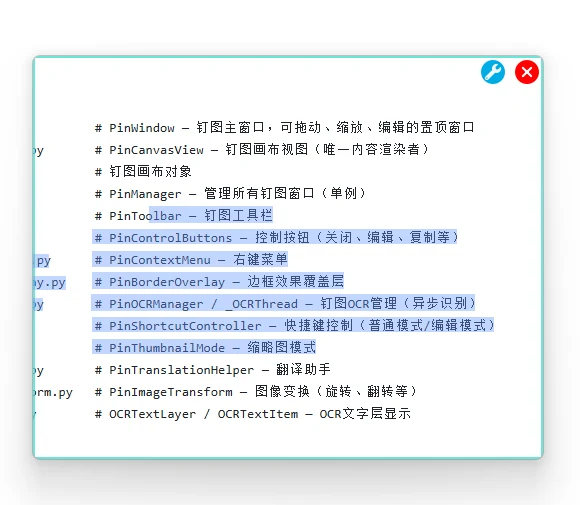
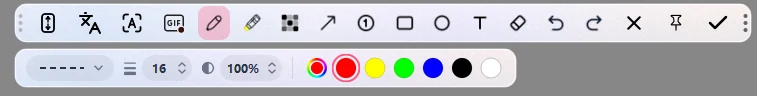
제작사 README의 실제 편집 GIF에서 본 영역 선택 화면과 OCR 결과 창, 2.1.5 릴리스의 새 도구막대입니다. 편집 GIF의 촬영 버전은 명시되지 않았으므로 최신판 전체 화면이라고 단정하지 않습니다.
| 프로그램 | jietuba |
| 제작 | 1003129155 |
| 라이선스 | MIT |
| 대표 작업 | 긴 캡처·OCR |
| 공식 배포 | GitHub Releases 2.1.5 |
Windows x64 Full 파일을 고르는 이유
2.1.5 릴리스에는 x64와 ARM64 각각에 Full PP와 Lite ZIP이 있습니다. 보통의 64비트 Intel·AMD Windows PC는 이름 끝이 x64.zip인 파일을, ARM 기반 Windows PC는 arm64.zip인 파일을 고릅니다. 이 글의 공식 버튼은 PP-OCR 모델이 포함된 jietuba_pp-release-2.1.5-x64.zip 한 파일을 가리킵니다.
Full ZIP에는 jietuba_pp.exe와 models 폴더가 함께 들어 있습니다. 압축을 풀 때 폴더 구조를 유지해야 PP-OCR 모델을 찾을 수 있습니다. 설치 프로그램을 실행하는 방식이 아닌 휴대용 배포이며, 공식 안내는 압축을 푼 뒤 EXE를 열도록 설명합니다. Lite는 파일 크기가 작지만 Windows 11 캡처 도구의 글자 인식 기능이 없거나 오래된 PC에서는 OCR을 쓸 수 없습니다.
- Windows 시스템 정보에서 x64인지 ARM64인지 확인합니다.
- x64라면 공식 2.1.5 릴리스의 Full PP x64 ZIP을 찾습니다.
- 압축을 풀 때 EXE와 models 폴더를 같은 배포 폴더에 둡니다.
스크롤 화면을 한 장으로 이어 캡처하기
jietuba의 캡처를 시작해 길게 남길 웹페이지나 문서의 본문 영역을 선택합니다. 편집 화면 아래 도구막대에서 세로 스크롤 모양의 긴 캡처 도구를 고릅니다. 캡처할 영역에 메뉴나 고정 광고가 자꾸 끼어들면 범위를 조금 좁히고, 제목부터 마지막 문단까지 실제로 이어질 부분을 먼저 정하세요.
스크롤 막대나 키보드로 화면을 조금씩 내려가면 프로그램이 바뀐 화면을 감지해 겹치는 부분을 이어 붙입니다. 같은 구간을 다시 올려 보는 것은 위치를 잡는 데 쓸 수 있지만, 중간을 크게 건너뛰면 연결이 어려울 수 있습니다. 끝까지 이동한 뒤 미리보기에서 문단 경계가 겹치거나 빠진 곳이 없는지 확인하고 결과를 이미지로 저장하세요.
2.1.5에서는 예전 설명에서 보던 ‘수동 스크린샷’ 버튼과 ‘스크롤 후 캡처 대기 시간’ 설정이 제거됐습니다. 현재 화면에 없는 버튼을 찾느라 시간을 쓰기보다 화면 변화 감지 방식으로 이어지는지 확인하면 됩니다.
- 캡처를 시작해 이어 붙일 본문 영역을 지정합니다.
- 긴 캡처 도구를 선택하고 화면을 조금씩 아래로 이동합니다.
- 미리보기에서 빠진 줄과 중복된 줄을 확인합니다.
- 결과 이미지를 저장하고 전체 길이를 다시 엽니다.
캡처 이미지에서 글자를 선택해 복사하기
글자를 꺼낼 때는 화면을 이미지로 저장하는 것으로 끝나지 않습니다. 캡처 영역에서 글자 인식 모양의 OCR 도구를 선택하면 결과 창에 인식된 글자 위치가 표시됩니다. 공식 화면에는 인식된 여러 줄을 드래그해 선택한 모습이 보입니다. 필요한 줄만 고른 뒤 복사해 메모장 등에 붙여 넣고 빠진 글자와 줄바꿈을 원본 이미지와 비교하세요.
OCR 결과가 비어 있다면 설정의 OCR Settings에서 엔진 상태를 확인합니다. Windows 11 캡처 도구의 OCR을 쓴다면 캡처 도구에 ‘텍스트 작업’이 있는지와 버전이 11.2308 이상인지 확인하세요. 그 기능이 없는 환경에서 Lite를 받았다면 Full PP 패키지의 모델 포함 여부를 확인하고 엔진을 바꿉니다. 글자가 흐리거나 너무 작다면 캡처 범위를 줄여 다시 인식해 보세요.
인식된 문장은 이미지에 찍힌 글자를 해석한 결과이므로 표의 열 순서나 특수문자가 달라질 수 있습니다. 숫자·주소·코드처럼 한 글자 차이가 중요한 내용은 원본과 대조한 뒤 사용하세요. 글자 추출을 위해 번역 기능까지 켤 필요는 없습니다.
- 글자가 포함된 부분을 캡처합니다.
- 도구막대에서 OCR 글자 인식 도구를 선택합니다.
- 결과 창에서 필요한 문장을 선택해 복사합니다.
- 붙여 넣은 글자를 원본과 대조합니다.
패키지와 인식 엔진에서 막힐 때
긴 화면이 중간에서 끊기면 같은 내용이 조금씩 겹치도록 스크롤해 보세요. 문서의 팝업이나 고정 요소가 캡처 영역을 덮으면 화면 내용이 바뀌어도 이어 붙일 기준이 흐려집니다. 팝업을 닫거나 본문만 다시 선택한 다음 결과 이미지의 경계를 확인하세요.
Full을 풀었는데 PP-OCR이 보이지 않으면 EXE만 따로 옮기지 않았는지 확인합니다. 공식 안내는 models 폴더를 jietuba_pp.exe 옆에 두도록 합니다. 반대로 Windows 11 캡처 도구 OCR이 있다면 자동 설정에서 그 엔진을 먼저 사용할 수 있습니다. 어떤 엔진이 선택됐는지 OCR Settings를 확인한 뒤 한 문장만 테스트해 보세요.
보안 경고가 나와도 경고를 무조건 무시하지 마세요. 브라우저의 다운로드 기록, GitHub 릴리스 주소, 파일명과 PC 아키텍처를 다시 대조하고 출처가 다르면 파일을 열지 않는 편이 안전합니다. 제작사는 배포 빌드와 코드 서명 정책을 공식 README에 설명하지만, 링크를 거쳐 온 파일이 같은 것인지는 사용자가 확인해야 합니다.
- 끊긴 긴 캡처는 겹치는 본문이 보이도록 다시 이동합니다.
- OCR이 비면 패키지 종류와 models 폴더, 선택한 엔진을 확인합니다.
- 파일 경고가 있으면 공식 주소와 파일명을 대조합니다.
캡처를 다른 작업에 이어 쓰기
스크롤 캡처로 만든 긴 이미지가 너무 길다면 필요한 부분만 잘라 공유하고, 전체 원본은 따로 보관하세요. 문장만 필요한 경우에는 OCR 결과에서 필요한 줄을 선택해 복사하는 편이 이미지를 통째로 전달하는 것보다 간단합니다. 반대로 화면의 배치나 그림까지 증거로 남겨야 한다면 원본 이미지를 같이 저장해야 합니다.
jietuba의 화면 고정 기능은 캡처한 이미지를 다른 창 위에 띄워 비교할 때 유용합니다. 공식 자료에는 고정된 이미지에서 확대·편집·OCR을 다시 실행할 수 있다고 나옵니다. 같은 문서를 여러 번 열지 않고 참고하려면 이미지로 고정해 두고, 끝난 뒤에는 창을 닫으세요.
이 프로그램에는 GIF·MP4 녹화와 번역도 있지만 긴 문서 캡처·글자 추출을 끝내는 데 꼭 필요한 단계는 아닙니다. 먼저 한 장을 끊김 없이 저장하고 한 문장을 정확히 복사하는지 확인한 뒤 다른 기능을 살펴보면 설정을 덜 헷갈립니다.
- 긴 캡처 원본 이미지를 저장합니다.
- 공유할 부분만 따로 잘라 냅니다.
- 글자는 OCR로 복사하고 원본과 비교합니다.
자주 묻는 질문
jietuba는 무료인가요?
네. 공식 2.1.5 GitHub 릴리스에서 Windows ZIP을 무료로 받을 수 있고 저장소의 앱 라이선스는 MIT입니다.
x64 PC에서 어떤 ZIP을 고르나요?
OCR 모델까지 포함하려면 jietuba_pp-release-2.1.5-x64.zip을 고르세요. ARM64 파일과 혼동하지 마세요.
Lite도 이미지 글자를 읽을 수 있나요?
Windows 11 캡처 도구 11.2308 이상에 텍스트 작업이 있어야 합니다. 그렇지 않다면 Full PP 패키지가 필요합니다.
긴 캡처가 중간에서 끊겨요.
캡처 영역에 반복되는 고정 요소가 없는지 보고, 본문이 조금씩 겹치도록 이동한 뒤 미리보기의 경계를 확인하세요.
OCR 결과를 어디에서 복사하나요?
OCR 결과 창에서 필요한 글자를 선택해 복사합니다. 붙여 넣은 뒤 원본 이미지와 숫자·특수문자를 대조하세요.
긴 화면을 저장하고 필요한 글자만 꺼내 보세요
Windows x64에서 jietuba Full PP 2.1.5 ZIP을 고른 뒤 캡처 영역을 정해 스크롤 화면을 한 장으로 이어 보세요. 저장한 이미지의 문단 경계가 자연스러운지 확인하면 긴 화면 보관을 마칠 수 있습니다.
글자만 옮길 때는 OCR 결과에서 필요한 부분을 복사하고 원본과 한 번 대조하세요. 인식이 비었다면 Lite·Full 패키지와 OCR 엔진 설정을 구분해 확인하면 됩니다.
공식 자료와 확인일
jietuba 공식 저장소와 사용 안내 · jietuba 2.1.5 공식 릴리스 · jietuba 공식 영어 README | 2026년 10월 12일 확인